
GPT-5.6 Sol API
GPT-5.6 Sol è il modello di punta della serie GPT-5.6 di OpenAI, descritto come modello di riferimento per l'intelligenza e il miglior modello per il coding, con una modalità Ultra che scompone i compiti complessi in sotto-attività eseguite in parallelo.
GPT-5.6 Sol è il modello di punta della serie GPT-5.6 di OpenAI, posizionato come il modello con la più alta intelligenza della famiglia. OpenAI lo descrive come un modello da lavoro e il miglior modello per il coding. La modalità Ultra scompone i compiti complessi in sotto-attività eseguite da sub-agenti paralleli e unisce i risultati in un'unica risposta; l'orchestrazione avviene interamente nel livello di ragionamento, senza che gli sviluppatori debbano gestire i passaggi intermedi. Il modello gestisce pianificazione multi-file, chiamate sequenziali di strumenti, recupero da fallimenti intermedi e output finale coerente, oltre a compiti di codice, testo e immagini in un'unica chiamata. Supporta punti di cache espliciti con una durata minima della cache di 30 minuti.
Grazie a queste capacità, GPT-5.6 Sol è adatto a agenti di coding complessi, ricerca a lungo orizzonte, uso del computer, difesa informatica, ricerca scientifica, design e flussi di lavoro professionali complessi. Si distingue nei compiti che richiedono pianificazione, iterazione ed esecuzione, con un miglioramento dell'efficienza dei token del 54% complessivo. Su ExploitBench eguaglia Mythos Preview usando circa un terzo dei token di output, e nell'analisi biologica e genomica a lungo orizzonte ottiene risultati migliori di GPT-5.5 con meno token.
Non è conveniente per la generazione semplice di funzioni, non è adatto all'autocompletamento IDE sensibile alla latenza né a compiti che richiedono ragionamento formale deterministico, per i quali è consigliata la serie o (o3, o4-mini). Modelli più piccoli ed economici come GPT-4.1 mini e o4-mini sono più convenienti per alcuni compiti.
Aggiornato:
ID MODELLO
gpt-5.6-sol- Contesto
- 1.05M
- Output max
- 128K
- API consigliata
- responses
- Input
- file / image / text
- Output
- text
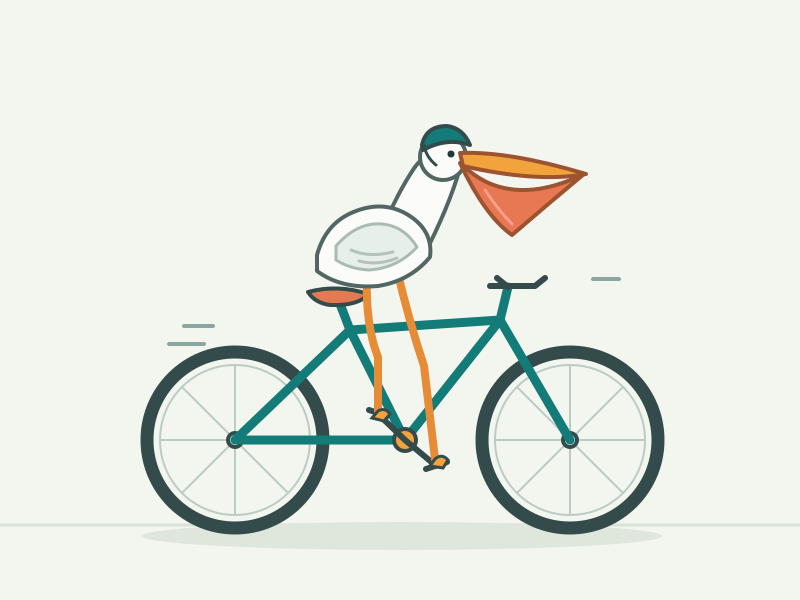
Scopri il pellicano di questo modello
Scopri cosa ha creato GPT-5.6 Sol a partire dallo stesso prompt.
In evidenza
- Modello di punta della serie GPT-5.6
- Modalità Ultra con sub-agenti paralleli
- Efficienza dei token migliorata del 54%
- Pianificazione multi-file e recupero da errori
- Cache esplicita con durata minima di 30 minuti
Fornitori
Confronta i prezzi delle API tra fornitori. Seleziona un fornitore per vedere tutti i costi e le condizioni.
| Disponibilità | ||||
|---|---|---|---|---|
| $4 | $20 | $0.4 | ||
| $2 | $10 | $0.2 | ||
| $4 | $20 | $0.4 | ||
| $8 | $40 | $0.8 |
Le statistiche storiche non sono un controllo in tempo reale. I dati mancanti non indicano un guasto.
Cosa acquisti con $10
- Input
- 2,5 Mln token
- Output
- 500K token
Stima basata sui prezzi attuali di input e output, esclusi gli sconti.
Benchmark
- 80
Coding Agent Index
punti
- 88,8%
Coding Agent Index (modalità Ultra)
rispetto a Claude Mythos 5 88,0% e GPT-5.5 83,4%
- 91,9%
Modalità Ultra
percentuale
Punteggi come pubblicati dal fornitore del modello.
Ragionamento
- Sforzo predefinito
- medium
- Attivo per impostazione predefinita
- Sì
- Sempre attivo
- No
- Livelli di sforzo disponibili
- max / xhigh / high / medium / low / none
Avvio rapido
Codice pronto all'uso per chiamare questo modello con le API compatibili di Felo API Platform. Inizia nel Playground se vuoi testare i prompt prima di scrivere codice.
Imposta la chiave API
Crea una chiave dal tuo account Felo API Platform e impostala come variabile d'ambiente.
export FELO_API_KEY="YOUR_API_KEY"Invia la prima richiesta
Usa questo ID modello con l'endpoint Felo API Platform. Le intestazioni facoltative come X-Request-Id aiutano nella risoluzione dei problemi.
gpt-5.6-solQuesto modello è in grado di ragionare. Se il protocollo selezionato e la route del modello espongono controlli di ragionamento, conserva i metadati di ragionamento restituiti quando continui la conversazione.
const response = await fetch("https://openapi.felo.ai/api/v1/responses", {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.FELO_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
  "model": "gpt-5.6-sol",
  "input": "Hello"
}),
});
if (!response.ok) throw new Error(await response.text());
console.log(await response.json());
Usare SDK di terze parti
Negli SDK compatibili imposta baseURL su https://openapi.felo.ai/api/v1. Per i client in stile Claude, usa la base URL compatibile con Anthropic. https://openapi.felo.ai/api.
Attiva lo streaming
Aggiungi stream: true per ricevere le risposte come server-sent events.
curl -N https://openapi.felo.ai/api/v1/responses \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "gpt-5.6-sol",
  "input": "Hello",
  "stream": true
}'
Endpoint
Felo API Platform espone superfici compatibili per le chiamate ai modelli. Scegli la superficie che la tua app o il tuo client agente già supporta.
Responses
Richieste compatibili con Responses per agenti e flussi di lavoro.
POST
https://openapi.felo.ai/api/v1/responsesParametri
modelstringgpt-5.6-solID pubblico del modello da chiamare.inputstring | array——seed———toolsarray—Definizioni di tool calling secondo lo schema compatibile.reasoning———verbosity———max_tokensinteger—Numero massimo di token generati.tool_choicestring or object—Controlla se uno strumento deve essere chiamato.response_formatobject—Richiede output strutturato quando supportato.reasoning_effort———include_reasoning———structured_outputs———max_completion_tokens———Domande frequenti
Cos'è GPT-5.6 Sol?
GPT-5.6 Sol è il modello di punta della serie GPT-5.6 di OpenAI, posizionato come il modello con la più alta intelligenza della famiglia. OpenAI lo descrive come un modello da lavoro e il miglior modello per il coding. La modalità Ultra scompone i compiti complessi in sotto-attività eseguite da sub-agenti paralleli e unisce i risultati in un'unica risposta; l'orchestrazione avviene interamente nel livello di ragionamento, senza che gli sviluppatori debbano gestire i passaggi intermedi. Il modello gestisce pianificazione multi-file, chiamate sequenziali di strumenti, recupero da fallimenti intermedi e output finale coerente, oltre a compiti di codice, testo e immagini in un'unica chiamata. Supporta punti di cache espliciti con una durata minima della cache di 30 minuti. Grazie a queste capacità, GPT-5.6 Sol è adatto a agenti di coding complessi, ricerca a lungo orizzonte, uso del computer, difesa informatica, ricerca scientifica, design e flussi di lavoro professionali complessi. Si distingue nei compiti che richiedono pianificazione, iterazione ed esecuzione, con un miglioramento dell'efficienza dei token del 54% complessivo. Su ExploitBench eguaglia Mythos Preview usando circa un terzo dei token di output, e nell'analisi biologica e genomica a lungo orizzonte ottiene risultati migliori di GPT-5.5 con meno token. Non è conveniente per la generazione semplice di funzioni, non è adatto all'autocompletamento IDE sensibile alla latenza né a compiti che richiedono ragionamento formale deterministico, per i quali è consigliata la serie o (o3, o4-mini). Modelli più piccoli ed economici come GPT-4.1 mini e o4-mini sono più convenienti per alcuni compiti.
Come viene addebitato l'utilizzo?
La fattura dipende dal fornitore che usi, dai suoi prezzi e dal tuo utilizzo. Input più lunghi o altre condizioni possono avere prezzi diversi.
Quali tipi di input e output supporta GPT-5.6 Sol?
Accetta input testuali, immagini, audio e video, e produce output testuali, immagini, audio ed embedding. Gestisce inoltre compiti di codice, testo e immagini in un'unica chiamata.
Qual è la lunghezza del contesto e il limite di output?
Il contesto è di circa 1,05 milioni di token (1,1 milioni secondo alcune fonti) e il limite di output è di 128.000 token.
A cosa serve la modalità Ultra?
Scompone i compiti complessi in sotto-attività eseguite da sub-agenti paralleli e unisce i risultati in un'unica risposta. L'orchestrazione avviene interamente nel livello di ragionamento, quindi gli sviluppatori non devono gestire i passaggi intermedi.
Per quali compiti è meno adatto?
Non è conveniente per la generazione semplice di funzioni e non è adatto all'autocompletamento IDE sensibile alla latenza. Per compiti che richiedono ragionamento formale deterministico è consigliata la serie o (o3, o4-mini).
Come si comporta rispetto a GPT-5.5?
Su ExploitBench eguaglia Mythos Preview usando circa un terzo dei token di output, e nell'analisi biologica e genomica a lungo orizzonte ottiene risultati migliori di GPT-5.5 con meno token.
Modelli correlati
GPT-6.1 Terra Pro
OpenAIgpt-6.1-terra-proGPT-6.1 Terra Pro è il modello di ragionamento di fascia media di OpenAI basato su GPT-6.1 Terra, con reasoning.mode impostato su pro, pensato per compiti complessi dove l'accuratezza conta più di costi e tempi.
Contesto
1.05M
Output max
128K
Token di input · Tariffa base
$1 / 1M token
Token di output · Tariffa base
$5 / 1M token
GPT-6.1 Terra
OpenAIgpt-6.1-terraGPT-6.1 Terra è il modello bilanciato della serie GPT-6.1 di OpenAI, veloce ed efficiente per il lavoro professionale quotidiano, con input testuali e visivi e output testuale.
Contesto
1.05M
Output max
128K
Token di input · Tariffa base
$1 / 1M token
Token di output · Tariffa base
$5 / 1M token
GPT-6.1 Sol
OpenAIgpt-6.1-solGPT-6.1 Sol è un modello OpenAI quasi-Astra con contesto da 1.050.000 token, ideale per coding agentico, uso del computer e lavoro professionale su documenti.
Contesto
1.05M
Output max
128K
Token di input · Tariffa base
$2 / 1M token
Token di output · Tariffa base
$10 / 1M token
GPT-6 Luna
OpenAIgpt-6-lunaGPT-6 Luna è il modello più efficiente della famiglia GPT-6 di OpenAI, veloce ed economico, con una finestra di contesto di 1.050.000 token, output solo testuale e controllo dello sforzo di ragionamento.
Contesto
1.05M
Output max
128K
Token di input · Tariffa base
$0.1 / 1M token
Token di output · Tariffa base
$0.5 / 1M token
GPT-6 Astra
OpenAIgpt-6-astraGPT-6 Astra è il modello OpenAI più intelligente e allineato, progettato come operatore informatico per ragionamento avanzato, coding e automazione di workflow complessi.
Contesto
1.05M
Output max
128K
Token di input · Tariffa base
$10 / 1M token
Token di output · Tariffa base
$50 / 1M token
GPT-5.6 Luna
OpenAIgpt-5.6-lunaGPT-5.6 Luna è il modello più leggero e conveniente della serie GPT-5.6 di OpenAI, ottimizzato per bassa latenza e compiti ad alto volume con una finestra di contesto di 1.000.000 token.
Contesto
1.05M
Output max
128K
Token di input · Tariffa base
$0.2 / 1M token
Token di output · Tariffa base
$1.2 / 1M token