
Kimi K3.1 Pro Highspeed API
Kimi K3.1 Pro Highspeed adalah model open-weight kelas 3 triliun parameter dari Moonshot AI dengan konteks 1.000.000 token, kecepatan output 2–3 kali lebih cepat dari Kimi K3.1 Pro standar, dan kemampuan yang sama.
Kimi K3.1 Pro Highspeed adalah model open-weight kelas 3 triliun parameter dari Moonshot AI yang menerima input teks dan gambar serta menghasilkan output teks. Model ini mempertahankan kemampuan yang sama dengan Kimi K3.1 Pro standar, termasuk pemahaman visual bawaan, kemampuan menulis dan menjalankan skrip untuk Blender dan perangkat lunak CAD, serta alur kerja penalaran dan pengambilan keputusan multi-langkah. Dengan jendela konteks 1.000.000 token, model ini cocok untuk tugas-tugas yang melibatkan dokumen panjang dan riwayat percakapan yang ekstensif.
Model ini unggul dalam tugas pengkodean jangka panjang, pembuatan model 3D, riset dan pemodelan keuangan, serta tugas agen jangka panjang. Kemampuannya dalam pemodelan parametrik dan penanganan alur kerja investasi penuh—dari penyaringan hingga analisis profitabilitas—menjadikannya pilihan untuk aplikasi yang membutuhkan kecepatan respons tinggi. Varian Highspeed ini diposisikan sebagai pelengkap versi standar: versi standar untuk tugas latar belakang yang sensitif terhadap biaya, sedangkan Highspeed untuk aplikasi interaktif dan layanan online yang membutuhkan umpan balik cepat.
Dibandingkan dengan Kimi K3, model ini menunjukkan peningkatan signifikan: tingkat halusinasi turun dari 23,4% menjadi 8,3%, proporsi respons dengan setidaknya satu kesalahan faktual menjadi 42,4% dari generasi sebelumnya, dan kinerja operasional bisnis sekitar 4,2 kali lipat. Model ini tersedia di Kimi.ai, Kimi Work, Kimi Code, dan Kimi API dengan pengenal model API kimi-k3.1-pro-highspeed. Konsekuensi dari kecepatan tinggi adalah konsumsi sekitar dua kali lipat versi standar.
Diperbarui:
ID MODEL
kimi-k3.1-pro-highspeed- Konteks
- 1.049M
- Output maks
- 1.049M
- API yang direkomendasikan
- messages
- Masukan
- text / image / video
- Keluaran
- text
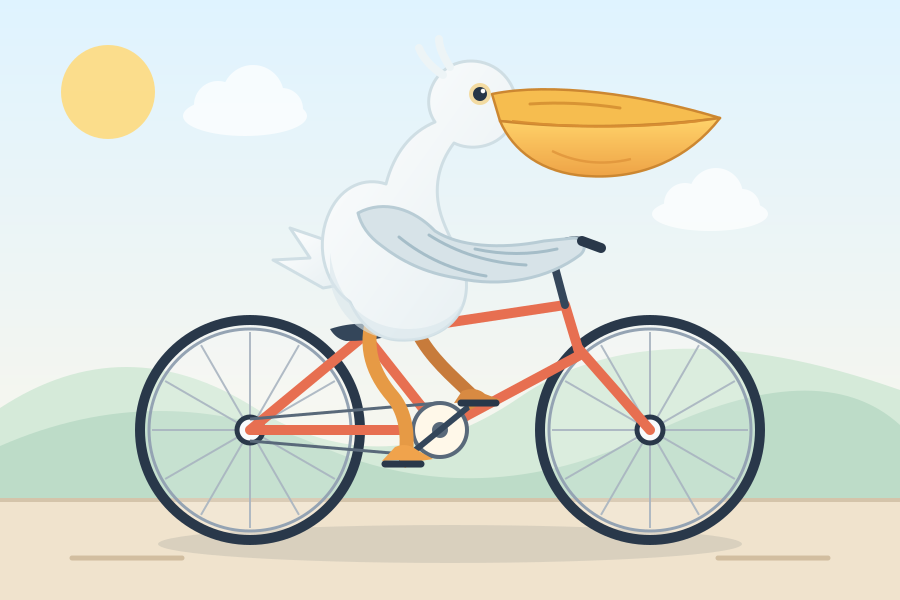
Lihat pelikan buatan model ini
Lihat karya Kimi K3.1 Pro Highspeed dari perintah yang sama.
Sorotan
- Kecepatan output 2–3 kali Kimi K3.1 Pro standar
- Konteks 1.000.000 token
- Model open-weight kelas 3 triliun parameter
- Pemahaman visual bawaan
- Dukungan skrip Blender dan CAD
- Konsumsi daya sekitar dua kali versi standar
Penyedia
Harga terbaikBandingkan harga API antarpenyedia. Pilih penyedia untuk melihat semua biaya dan ketentuan.
| Ketersediaan | ||||
|---|---|---|---|---|
Statistik historis bukan pemeriksaan langsung. Data yang hilang tidak berarti gangguan.
Yang bisa dibeli dengan $10
- Masukan
- 2,5 jt token
- Keluaran
- 500 rb token
Perkiraan dari harga masukan dan keluaran saat ini, sebelum diskon.
Tolok ukur
- 67%
Terminal-Bench 4.0
Kimi K3.1 Pro standar; peringkat 1, di atas GPT-6 Astra pada 58,2%
- #4
Peringkat Artificial Analysis
Peringkat global Kimi K3.1 Pro standar
- 61,2%
Uji kode jangka panjang
Kimi K3.1 Pro standar; K3 mencetak 55,95%
- 7,2
Pemodelan keuangan
Peningkatan poin dibanding K3, Kimi K3.1 Pro standar
- 11,6
Riset keuangan
Peningkatan poin dibanding K3, Kimi K3.1 Pro standar
Skor sesuai publikasi penyedia model.
Mulai cepat
Kode siap pakai untuk memanggil model ini dengan API yang kompatibel dari Felo API Platform. Mulai di Playground jika Anda ingin menguji prompt sebelum menulis kode.
Siapkan kunci API
Buat kunci dari akun Felo API Platform Anda dan tetapkan sebagai variabel lingkungan.
export FELO_API_KEY="YOUR_API_KEY"Kirim permintaan pertama
Gunakan ID model ini dengan endpoint Felo API Platform. Header permintaan opsional seperti X-Request-Id dapat membantu pemecahan masalah.
kimi-k3.1-pro-highspeedconst response = await fetch("https://openapi.felo.ai/api/v1/messages", {
method: 'POST',
headers: {
Authorization: `Bearer ${process.env.FELO_API_KEY}`,
'Content-Type': 'application/json',
},
body: JSON.stringify({
"model": "kimi-k3.1-pro-highspeed",
"max_tokens": 1024,
"messages": [
{
"role": "user",
"content": "Hello"
}
]
}),
});
if (!response.ok) throw new Error(await response.text());
console.log(await response.json());Menggunakan SDK pihak ketiga
Pada SDK yang kompatibel, tetapkan baseURL ke https://openapi.felo.ai/api/v1. Untuk klien bergaya Claude, gunakan base URL yang kompatibel dengan Anthropic. https://openapi.felo.ai/api.
Aktifkan streaming
Tambahkan stream: true untuk menerima respons sebagai server-sent events.
curl -N https://openapi.felo.ai/api/v1/messages \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kimi-k3.1-pro-highspeed",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ],
  "stream": true
}'
Endpoint
Felo API Platform menyediakan antarmuka pemanggilan model yang kompatibel. Pilih antarmuka yang sudah didukung aplikasi atau klien agen Anda.
Messages
Pesan yang kompatibel dengan Anthropic untuk klien bergaya Claude.
POST
https://openapi.felo.ai/api/v1/messagesParameter
modelstringkimi-k3.1-pro-highspeedID model publik yang akan dipanggil.max_tokensinteger—Jumlah maksimum token yang dihasilkan.messagesarray—Pesan percakapan untuk Chat Completions.Pertanyaan umum
Mengenal Kimi K3.1 Pro Highspeed?
Kimi K3.1 Pro Highspeed adalah model open-weight kelas 3 triliun parameter dari Moonshot AI yang menerima input teks dan gambar serta menghasilkan output teks. Model ini mempertahankan kemampuan yang sama dengan Kimi K3.1 Pro standar, termasuk pemahaman visual bawaan, kemampuan menulis dan menjalankan skrip untuk Blender dan perangkat lunak CAD, serta alur kerja penalaran dan pengambilan keputusan multi-langkah. Dengan jendela konteks 1.000.000 token, model ini cocok untuk tugas-tugas yang melibatkan dokumen panjang dan riwayat percakapan yang ekstensif. Model ini unggul dalam tugas pengkodean jangka panjang, pembuatan model 3D, riset dan pemodelan keuangan, serta tugas agen jangka panjang. Kemampuannya dalam pemodelan parametrik dan penanganan alur kerja investasi penuh—dari penyaringan hingga analisis profitabilitas—menjadikannya pilihan untuk aplikasi yang membutuhkan kecepatan respons tinggi. Varian Highspeed ini diposisikan sebagai pelengkap versi standar: versi standar untuk tugas latar belakang yang sensitif terhadap biaya, sedangkan Highspeed untuk aplikasi interaktif dan layanan online yang membutuhkan umpan balik cepat. Dibandingkan dengan Kimi K3, model ini menunjukkan peningkatan signifikan: tingkat halusinasi turun dari 23,4% menjadi 8,3%, proporsi respons dengan setidaknya satu kesalahan faktual menjadi 42,4% dari generasi sebelumnya, dan kinerja operasional bisnis sekitar 4,2 kali lipat. Model ini tersedia di Kimi.ai, Kimi Work, Kimi Code, dan Kimi API dengan pengenal model API kimi-k3.1-pro-highspeed. Konsekuensi dari kecepatan tinggi adalah konsumsi sekitar dua kali lipat versi standar.
Bagaimana penggunaan ditagih?
Tagihan Anda bergantung pada penyedia yang digunakan, tarifnya, dan penggunaan Anda. Masukan yang lebih panjang atau ketentuan lain dapat memiliki harga berbeda.
Apa saja modalitas input yang didukung Kimi K3.1 Pro Highspeed?
Model ini menerima input teks dan gambar, serta menghasilkan output teks.
Berapa panjang konteks yang didukung?
Kimi K3.1 Pro Highspeed memiliki jendela konteks 1.000.000 token.
Apa perbedaan utama antara Kimi K3.1 Pro Highspeed dan Kimi K3.1 Pro standar?
Highspeed menawarkan kecepatan output sekitar 2–3 kali lebih cepat dari versi standar dengan kemampuan yang sama, tetapi konsumsi dayanya sekitar dua kali lipat. Versi standar lebih cocok untuk tugas latar belakang yang sensitif biaya, sedangkan Highspeed untuk aplikasi interaktif.
Tugas apa yang paling cocok untuk model ini?
Model ini cocok untuk tugas pengkodean jangka panjang, pembuatan model 3D, riset dan pemodelan keuangan, tugas agen jangka panjang, serta percakapan interaktif dan layanan online yang membutuhkan latensi rendah.
Di mana model ini tersedia?
Kimi K3.1 Pro Highspeed tersedia di Kimi.ai, Kimi Work, Kimi Code, dan Kimi API dengan pengenal model kimi-k3.1-pro-highspeed.
Bagaimana kinerja Kimi K3.1 Pro Highspeed dibandingkan Kimi K3?
Tingkat halusinasi Kimi K3.1 Pro turun dari 23,4% pada K3 menjadi 8,3%, proporsi respons dengan setidaknya satu kesalahan faktual menjadi 42,4% dari generasi sebelumnya, dan kinerja operasional bisnis sekitar 4,2 kali lipat K3.