
Kimi K3.1 Pro Highspeed API
Kimi K3.1 Pro Highspeed ist eine beschleunigte Variante des Kimi K3.1 Pro mit etwa zwei- bis dreifacher Ausgabegeschwindigkeit bei gleichen Fähigkeiten.
Kimi K3.1 Pro Highspeed ist ein offenes Modell von Moonshot AI, das Text- und Bildeingaben verarbeitet und Text ausgibt. Es verfügt über ein Kontextfenster von 1.000.000 Tokens und zählt zur Klasse der Modelle mit rund 3 Billionen Parametern. Die Highspeed-Variante bietet dieselben Fähigkeiten wie das Standardmodell Kimi K3.1 Pro, gibt Antworten jedoch etwa zwei- bis dreimal schneller aus. Der Verbrauch liegt dafür etwa doppelt so hoch wie bei der Standardgeschwindigkeit.
Das Modell eignet sich für langfristige Coding-Aufgaben, agentische Workflows über längere Zeiträume sowie für die Erstellung von 3D-Modellen, da es Skripte für Blender und CAD-Software schreiben und ausführen kann. Auch im Finanzbereich ist es stark: Es deckt vollständige Investment-Workflows von der Screening- bis zur Profitabilitätsanalyse ab. Durch die native visuelle Verständnisfähigkeit lassen sich zudem Bilder in Aufgaben einbeziehen.
Aufgrund der hohen Ausgabegeschwindigkeit ist Kimi K3.1 Pro Highspeed besonders für latenzkritische Online-Dienste, interaktive Konversationen und Code-Vervollständigung mit schnellem Feedback geeignet. Es ist als Ergänzung zum Standardmodell positioniert: Die Standardversion eignet sich für kostensensible Hintergrundaufgaben, die Highspeed-Variante für interaktive Anwendungen. Verfügbar ist es über Kimi.ai, Kimi Work, Kimi Code und die Kimi API; die API-Modellkennung lautet kimi-k3.1-pro-highspeed.
Aktualisiert:
MODELL-ID
kimi-k3.1-pro-highspeed- Kontext
- 1.049M
- Max. Ausgabe
- 1.049M
- Empfohlene API
- messages
- Eingabe
- text / image / video
- Ausgabe
- text
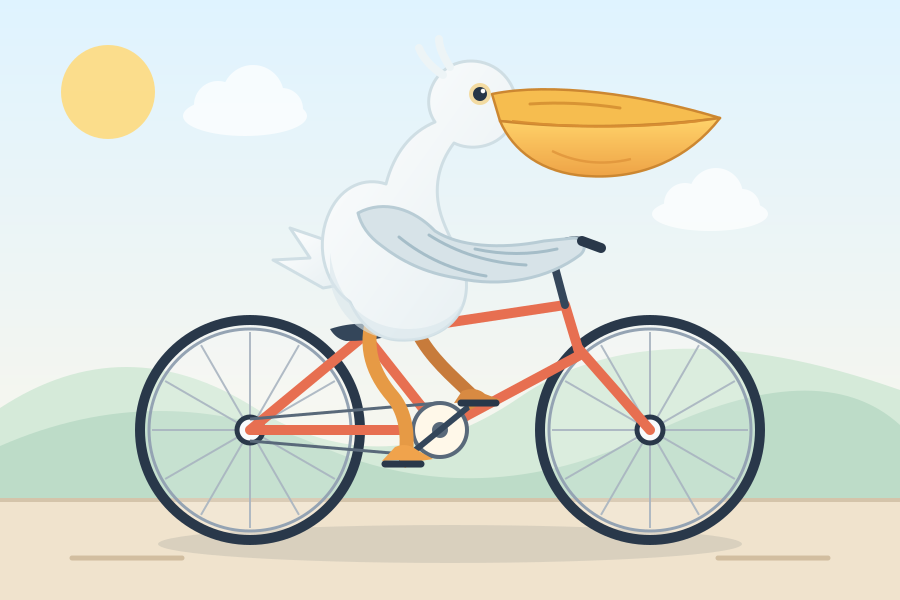
Den Pelikan dieses Modells ansehen
Sehen Sie, was Kimi K3.1 Pro Highspeed aus demselben Prompt gemacht hat.
Highlights
- Etwa 2- bis 3-fache Ausgabegeschwindigkeit
- Gleiche Fähigkeiten wie Kimi K3.1 Pro
- Offenes Modell der 3-Billionen-Parameter-Klasse
- 1.000.000-Token-Kontextfenster
- Native visuelle Verständnisfähigkeit
- Skripte für Blender und CAD
Anbieter
Bester PreisVergleichen Sie die API-Preise verschiedener Anbieter. Wählen Sie einen Anbieter aus, um alle Kosten und Bedingungen zu sehen.
| Verfügbarkeit | ||||
|---|---|---|---|---|
Historische Daten sind keine Live-Statusprüfung. Fehlende Daten bedeuten keinen Ausfall.
Was man für $10 bekommt
- Eingabe
- 2,5 Mio. Token
- Ausgabe
- 500.000 Token
Geschätzt anhand der aktuellen Eingabe- und Ausgabepreise, vor Rabatten.
Benchmarks
- 67%
Terminal-Bench 4.0
Standardmodell Kimi K3.1 Pro; Rang 1, vor GPT-6 Astra mit 58,2%
- 4.
Artificial Analysis Leaderboard
Globale Platzierung des Standardmodells Kimi K3.1 Pro
- 61,2%
Long-Horizon-Code-Test
Standardmodell Kimi K3.1 Pro; Kimi K3 erreichte 55,95%
- 7,2
Finanzmodellierung
Verbesserung in Punkten gegenüber Kimi K3, Standardmodell Kimi K3.1 Pro
- 11,6
Finanzresearch
Verbesserung in Punkten gegenüber Kimi K3, Standardmodell Kimi K3.1 Pro
Werte wie vom Modellanbieter veröffentlicht.
Schnellstart
Direkt einsetzbarer Code, um dieses Modell über die kompatiblen APIs der Felo API Platform aufzurufen. Testen Sie Prompts im Playground, bevor Sie Code schreiben.
API-Schlüssel hinterlegen
Erstellen Sie einen Schlüssel in Ihrem Konto bei der Felo API Platform und legen Sie ihn als Umgebungsvariable ab.
export FELO_API_KEY="YOUR_API_KEY"Erste Anfrage senden
Verwenden Sie diese Modell-ID mit dem Endpoint der Felo API Platform. Optionale Anfrage-Header wie X-Request-Id helfen bei der Fehlersuche.
kimi-k3.1-pro-highspeedconst response = await fetch("https://openapi.felo.ai/api/v1/messages", {
method: 'POST',
headers: {
Authorization: `Bearer ${process.env.FELO_API_KEY}`,
'Content-Type': 'application/json',
},
body: JSON.stringify({
"model": "kimi-k3.1-pro-highspeed",
"max_tokens": 1024,
"messages": [
{
"role": "user",
"content": "Hello"
}
]
}),
});
if (!response.ok) throw new Error(await response.text());
console.log(await response.json());Drittanbieter-SDKs verwenden
Setzen Sie in kompatiblen SDKs baseURL auf https://openapi.felo.ai/api/v1. Für Clients im Claude-Stil verwenden Sie die Anthropic-kompatible Basis-URL. https://openapi.felo.ai/api.
Streaming aktivieren
Fügen Sie stream: true hinzu, um Antworten als Server-Sent Events zu erhalten.
curl -N https://openapi.felo.ai/api/v1/messages \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kimi-k3.1-pro-highspeed",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ],
  "stream": true
}'
Endpoint
Die Felo API Platform stellt kompatible Oberflächen für Modellaufrufe bereit. Wählen Sie die Oberfläche, die Ihre App oder Ihr Agent-Client bereits unterstützt.
Messages
Anthropic-kompatible Nachrichten für Clients im Claude-Stil.
POST
https://openapi.felo.ai/api/v1/messagesParameter
modelstringkimi-k3.1-pro-highspeedÖffentliche Modell-ID, die aufgerufen wird.max_tokensinteger—Maximale Anzahl generierter Tokens.messagesarray—Gesprächsnachrichten für Chat Completions.Häufige Fragen
Was ist Kimi K3.1 Pro Highspeed?
Kimi K3.1 Pro Highspeed ist ein offenes Modell von Moonshot AI, das Text- und Bildeingaben verarbeitet und Text ausgibt. Es verfügt über ein Kontextfenster von 1.000.000 Tokens und zählt zur Klasse der Modelle mit rund 3 Billionen Parametern. Die Highspeed-Variante bietet dieselben Fähigkeiten wie das Standardmodell Kimi K3.1 Pro, gibt Antworten jedoch etwa zwei- bis dreimal schneller aus. Der Verbrauch liegt dafür etwa doppelt so hoch wie bei der Standardgeschwindigkeit. Das Modell eignet sich für langfristige Coding-Aufgaben, agentische Workflows über längere Zeiträume sowie für die Erstellung von 3D-Modellen, da es Skripte für Blender und CAD-Software schreiben und ausführen kann. Auch im Finanzbereich ist es stark: Es deckt vollständige Investment-Workflows von der Screening- bis zur Profitabilitätsanalyse ab. Durch die native visuelle Verständnisfähigkeit lassen sich zudem Bilder in Aufgaben einbeziehen. Aufgrund der hohen Ausgabegeschwindigkeit ist Kimi K3.1 Pro Highspeed besonders für latenzkritische Online-Dienste, interaktive Konversationen und Code-Vervollständigung mit schnellem Feedback geeignet. Es ist als Ergänzung zum Standardmodell positioniert: Die Standardversion eignet sich für kostensensible Hintergrundaufgaben, die Highspeed-Variante für interaktive Anwendungen. Verfügbar ist es über Kimi.ai, Kimi Work, Kimi Code und die Kimi API; die API-Modellkennung lautet kimi-k3.1-pro-highspeed.
Wie wird die Nutzung abgerechnet?
Ihre Rechnung hängt vom genutzten Anbieter, seinen Preisen und Ihrer Nutzung ab. Längere Eingaben oder andere Bedingungen können andere Preise haben.
Welche Eingaben und Ausgaben unterstützt Kimi K3.1 Pro Highspeed?
Das Modell verarbeitet Texteingaben und Bildeingaben und gibt Text aus. Es verfügt über natives visuelles Verständnis.
Wie groß ist das Kontextfenster?
Das Kontextfenster umfasst 1.000.000 Tokens.
Für welche Aufgaben ist das Modell geeignet?
Es eignet sich für langfristige Coding-Aufgaben, 3D-Modellerstellung, Finanzforschung und -modellierung, langfristige agentische Aufgaben sowie für latenzkritische interaktive Anwendungen.
Wie unterscheidet sich Highspeed vom Standardmodell Kimi K3.1 Pro?
Die Ausgabegeschwindigkeit ist etwa zwei- bis dreimal höher als beim Standardmodell, bei gleichen Fähigkeiten. Der Verbrauch liegt dafür etwa doppelt so hoch wie bei der Standardgeschwindigkeit.
Wo ist Kimi K3.1 Pro Highspeed verfügbar?
Es ist auf Kimi.ai, Kimi Work, Kimi Code und über die Kimi API verfügbar. Die API-Modellkennung lautet kimi-k3.1-pro-highspeed.