
GLM 5.3 API
GLM-5.3 di Z.ai è un modello linguistico open-weights con contesto fino a 1 milione di token, pensato per agenti di coding di lungo periodo e compiti cyber.
GLM-5.3 è un modello di Z.ai pubblicato il 14 agosto 2026, con contesto fino a 1 milione di token e input e output esclusivamente testuali. Condivide la stessa architettura Mixture-of-Experts da 743 miliardi di parametri di GLM-5.2: tutti i miglioramenti derivano dal post-training, non da modifiche architetturali. La modalità di ragionamento non è più disattivabile e offre tre livelli di impegno: low, high e max.
Il modello è progettato per agenti di coding di lungo periodo, compiti complessi di ingegneria del software, lavoro multi-step da riga di comando come refactor e triage CI, cicli di agenti di lunga durata e attività su scala repository. Supporta anche la diagnosi e l'ottimizzazione di infrastrutture di machine learning e compiti agentici più ampi oltre al coding. Secondo Z.ai è il modello open-weights più capace per il coding e raggiunge risultati all'avanguardia tra i modelli open-source su Terminal Bench 3.0 e Agents' Last Exam; è inoltre allo stato dell'arte su CyberGym per la scoperta di vulnerabilità.
Tra le funzionalità figurano streaming dei messaggi per risposte in tempo reale, function calling per l'integrazione di strumenti, caching del contesto per ottimizzare le conversazioni lunghe e output strutturato in formati come JSON. I pesi aperti sono attesi intorno alla fine di agosto 2026, dopo un ritardo di circa due settimane per la revisione di sicurezza; le versioni quantizzate sono disponibili tramite la community di Hugging Face. L'accesso è attualmente limitato al GLM Coding Plan e l'API del modello è disponibile solo tramite il protocollo compatibile con OpenAI Chat Completion.
Aggiornato:
ID MODELLO
glm-5.3- Contesto
- 1.049M
- Output max
- 943.718K
- API consigliata
- messages
- Input
- text
- Output
- text
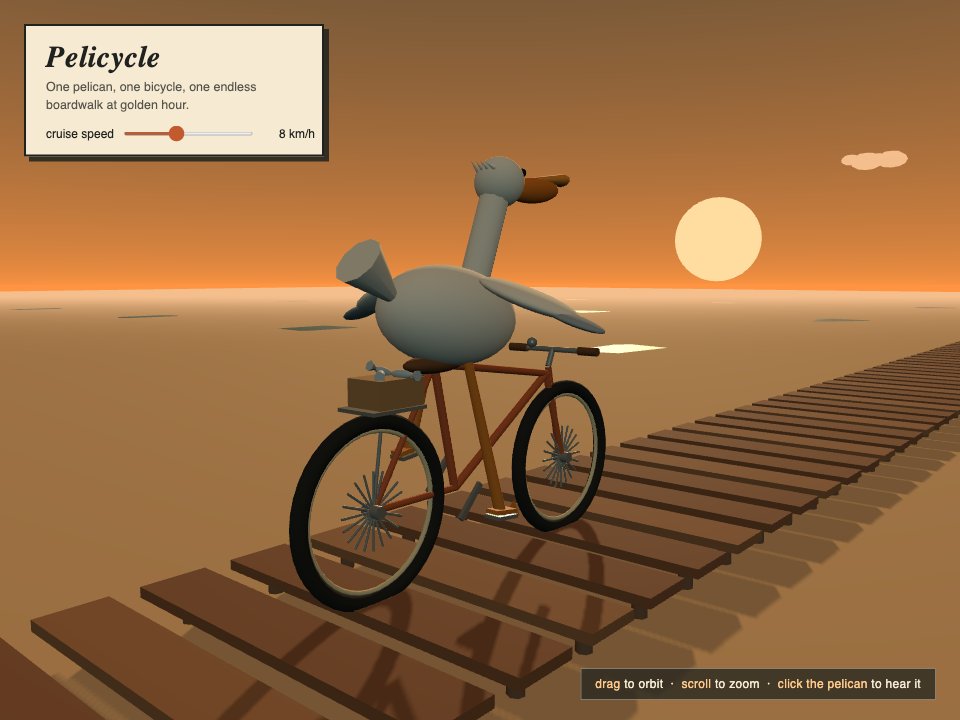
Scopri il pellicano di questo modello
Scopri cosa ha creato GLM 5.3 a partire dallo stesso prompt.
In evidenza
- Contesto fino a 1 milione di token
- Tre livelli di ragionamento: low, high, max
- Ragionamento non disattivabile
- Streaming e function calling
- Caching del contesto
- Output strutturato come JSON
Fornitori
Prezzo miglioreConfronta i prezzi delle API tra fornitori. Seleziona un fornitore per vedere tutti i costi e le condizioni.
| Disponibilità | ||||
|---|---|---|---|---|
| $1.4 | $4.4 | $0.26 | ||
| $0.7 | $2.2 | $0.13 | ||
| $0.91 | $2.86 | $0.169 | ||
| $1.053 | $2.15 | $0.356 | ||
| $1.19 | $3.74 | $0.238 | ||
| $1.4 | $4.4 | $0.14 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.68 | $5.28 | $0.312 |
Le statistiche storiche non sono un controllo in tempo reale. I dati mancanti non indicano un guasto.
Cosa acquisti con $10
- Input
- 7,1 Mln token
- Output
- 2,3 Mln token
Stima basata sui prezzi attuali di input e output, esclusi gli sconti.
Benchmark
- 50%
Code Bench
miglioramento rispetto a GLM-5.2, benchmark interno del fornitore
- 28.3
Terminal Bench 3.0
punti; GLM-5.2 ha ottenuto 4.6, un guadagno di 23.7 punti
- 66.9
DeepSWE v1.1
punti; in aumento da 46.2 su GLM-5.2, un miglioramento di 20.7 punti
- 28.5
Agents' Last Exam CLI
punti; in aumento da 23.8 su GLM-5.2
- 54.4%
ExploitBench
in aumento dal 24.4% su GLM-5.2
- 84.5%
CyberGym
benchmark per la scoperta di vulnerabilità
- 1769
GDPval-AA v2
punti su 44 categorie professionali
Punteggi come pubblicati dal fornitore del modello.
Ragionamento
- Sforzo predefinito
- max
- Attivo per impostazione predefinita
- Sì
- Sempre attivo
- Sì
- Livelli di sforzo disponibili
- max / high / low
Avvio rapido
Codice pronto all'uso per chiamare questo modello con le API compatibili di Felo API Platform. Inizia nel Playground se vuoi testare i prompt prima di scrivere codice.
Imposta la chiave API
Crea una chiave dal tuo account Felo API Platform e impostala come variabile d'ambiente.
export FELO_API_KEY="YOUR_API_KEY"Invia la prima richiesta
Usa questo ID modello con l'endpoint Felo API Platform. Le intestazioni facoltative come X-Request-Id aiutano nella risoluzione dei problemi.
glm-5.3Questo modello è in grado di ragionare. Se il protocollo selezionato e la route del modello espongono controlli di ragionamento, conserva i metadati di ragionamento restituiti quando continui la conversazione.
const response = await fetch("https://openapi.felo.ai/api/v1/messages", {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.FELO_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ]
}),
});
if (!response.ok) throw new Error(await response.text());
console.log(await response.json());
Usare SDK di terze parti
Negli SDK compatibili imposta baseURL su https://openapi.felo.ai/api/v1. Per i client in stile Claude, usa la base URL compatibile con Anthropic. https://openapi.felo.ai/api.
Attiva lo streaming
Aggiungi stream: true per ricevere le risposte come server-sent events.
curl -N https://openapi.felo.ai/api/v1/messages \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ],
  "stream": true
}'
Endpoint
Felo API Platform espone superfici compatibili per le chiamate ai modelli. Scegli la superficie che la tua app o il tuo client agente già supporta.
Messages
Messaggi compatibili con Anthropic per i client in stile Claude.
POST
https://openapi.felo.ai/api/v1/messagesParametri
modelstringglm-5.3ID pubblico del modello da chiamare.max_tokensinteger—Numero massimo di token generati.messagesarray—Messaggi della conversazione per Chat Completions.seed———stop———min_p———toolsarray—Definizioni di tool calling secondo lo schema compatibile.top_k———top_p———logprobs———reasoning———logit_bias———temperaturenumber—Controlla la varietà delle risposte quando supportato.tool_choicestring or object—Controlla se uno strumento deve essere chiamato.top_logprobs———response_formatobject—Richiede output strutturato quando supportato.presence_penalty———reasoning_effort———frequency_penalty———include_reasoning———repetition_penalty———structured_outputs———parallel_tool_calls———Domande frequenti
Cos'è GLM 5.3?
GLM-5.3 è un modello di Z.ai pubblicato il 14 agosto 2026, con contesto fino a 1 milione di token e input e output esclusivamente testuali. Condivide la stessa architettura Mixture-of-Experts da 743 miliardi di parametri di GLM-5.2: tutti i miglioramenti derivano dal post-training, non da modifiche architetturali. La modalità di ragionamento non è più disattivabile e offre tre livelli di impegno: low, high e max. Il modello è progettato per agenti di coding di lungo periodo, compiti complessi di ingegneria del software, lavoro multi-step da riga di comando come refactor e triage CI, cicli di agenti di lunga durata e attività su scala repository. Supporta anche la diagnosi e l'ottimizzazione di infrastrutture di machine learning e compiti agentici più ampi oltre al coding. Secondo Z.ai è il modello open-weights più capace per il coding e raggiunge risultati all'avanguardia tra i modelli open-source su Terminal Bench 3.0 e Agents' Last Exam; è inoltre allo stato dell'arte su CyberGym per la scoperta di vulnerabilità. Tra le funzionalità figurano streaming dei messaggi per risposte in tempo reale, function calling per l'integrazione di strumenti, caching del contesto per ottimizzare le conversazioni lunghe e output strutturato in formati come JSON. I pesi aperti sono attesi intorno alla fine di agosto 2026, dopo un ritardo di circa due settimane per la revisione di sicurezza; le versioni quantizzate sono disponibili tramite la community di Hugging Face. L'accesso è attualmente limitato al GLM Coding Plan e l'API del modello è disponibile solo tramite il protocollo compatibile con OpenAI Chat Completion.
Come viene addebitato l'utilizzo?
La fattura dipende dal fornitore che usi, dai suoi prezzi e dal tuo utilizzo. Input più lunghi o altre condizioni possono avere prezzi diversi.
Quali tipi di input e output supporta GLM-5.3?
GLM-5.3 accetta input testuali e produce output testuali.
Qual è la lunghezza massima del contesto?
Il modello supporta un contesto fino a 1 milione di token.
Quali livelli di ragionamento sono disponibili?
Sono disponibili tre livelli di impegno del ragionamento: low, high e max. La modalità di ragionamento non può più essere disattivata.
Per quali compiti è particolarmente adatto?
È pensato per agenti di coding di lungo periodo, compiti complessi di ingegneria del software, lavoro multi-step da riga di comando, cicli di agenti di lunga durata e attività su scala repository, oltre a compiti agentici più ampi.
In cosa differisce da GLM-5.2?
GLM-5.3 usa esattamente lo stesso modello di base di GLM-5.2, un'architettura Mixture-of-Experts da 743 miliardi di parametri; tutti i miglioramenti derivano dal post-training. Una differenza importante è che non consente più di disattivare il ragionamento.
Come si accede al modello?
L'accesso è attualmente limitato al GLM Coding Plan. L'API del modello è disponibile solo tramite il protocollo compatibile con OpenAI Chat Completion.
Modelli correlati
GLM 5.3 FlashX Legal
Z.aiglm-5.3-flashx-legalGLM 5.3 FlashX Legal è il modello di Z.ai per l'intelligenza legale agentica: input multimodale nativo, contesto di circa un milione di token e output fino a 128K token.
Contesto
1.049M
Output max
131.072K
Token di input
$0.37 / 1M token
Token di output
$1.25 / 1M token
GLM 5.3 Flash
Z.aiglm-5.3-flashGLM 5.3 Flash è un modello Mixture-of-Experts di Z.ai con 320 miliardi di parametri totali, contesto fino a un milione di token e input nativo multimodale per testo e immagini.
Contesto
1.049M
Output max
943.717K
Token di input
$0.15 / 1M token
Token di output
$0.5 / 1M token