
GLM 5.3 API
GLM-5.3 firmy Z.ai to model tekstowy z kontekstem do miliona tokenów, przeznaczony do długotrwałych zadań programistycznych i agentowych, z trybem myślenia o trzech poziomach wysiłku.
GLM-5.3 to model językowy od Z.ai wydany 14 sierpnia 2026 roku, obsługujący wyłącznie tekst na wejściu i wyjściu. Oferuje kontekst do miliona tokenów oraz tryb myślenia z trzema poziomami wysiłku — low, high i max. Myślenia nie można już wyłączyć, co jest zmianą niekompatybilną dla aplikacji działających wcześniej bez tego trybu. Model wspiera strumieniowanie odpowiedzi, wywoływanie funkcji, buforowanie kontekstu i ustrukturyzowane wyjście, m.in. w formacie JSON.
Model sprawdza się w długotrwałych pętlach agentowych, złożonych zadaniach inżynierii oprogramowania, wieloetapowej pracy w CLI, takiej jak refaktoryzacja i triage CI, a także w pracy na skalę całego repozytorium. Znajduje też zastosowanie w diagnostyce i optymalizacji infrastruktury ML oraz w szerszych zadaniach agentowych wykraczających poza programowanie.
GLM-5.3 korzysta z dokładnie tej samej bazy co GLM-5.2 — architektury Mixture-of-Experts z 743 miliardami parametrów — a wszystkie ulepszenia pochodzą z post-trainingu. Z.ai opisuje go jako najzdolniejszy model z otwartymi wagami do kodowania oraz wskazuje czołowe wyniki wśród modeli otwartoźródłowych na Terminal Bench 3.0 i Agents' Last Exam. Te same efekty ma osiągać przy około 50 000 tokenów zamiast 120 000. Ograniczeniem jest brak niezależnej replikacji wyników dostawcy oraz nadal znacząco niższe możliwości od aktualnych zamkniętych modeli frontier.
Zaktualizowano:
MODEL ID
glm-5.3- Kontekst
- 1.049M
- Maks. wyjście
- 943.718K
- Polecane API
- messages
- Wejście
- text
- Wyjście
- text
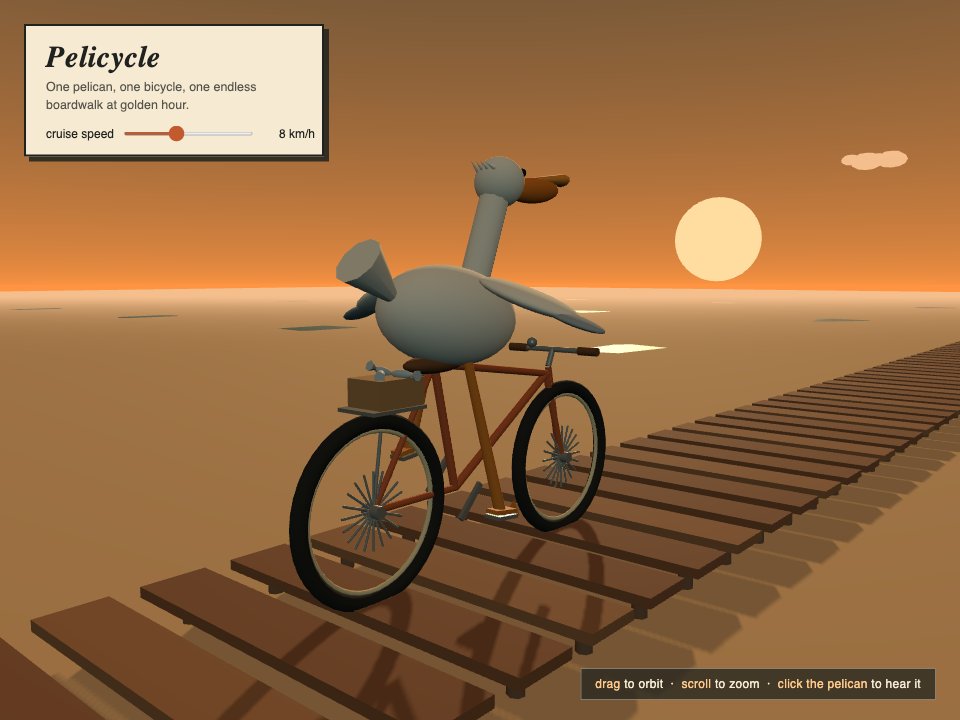
Zobacz pelikana tego modelu
Zobacz, co model GLM 5.3 stworzył na podstawie tego samego polecenia.
Najważniejsze informacje
- Kontekst do miliona tokenów
- Trzy poziomy wysiłku myślenia
- Myślenia nie można wyłączyć
- Wywoływanie funkcji i JSON
- Buforowanie kontekstu
- Strumieniowanie odpowiedzi
Dostawcy
Najlepsza cenaPorównaj ceny API u różnych dostawców. Wybierz dostawcę, aby zobaczyć wszystkie opłaty i warunki.
| Dostępność | ||||
|---|---|---|---|---|
| $1.4 | $4.4 | $0.26 | ||
| $0.7 | $2.2 | $0.13 | ||
| $0.91 | $2.86 | $0.169 | ||
| $1.053 | $2.15 | $0.356 | ||
| $1.19 | $3.74 | $0.238 | ||
| $1.4 | $4.4 | $0.14 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.68 | $5.28 | $0.312 |
Dane historyczne nie są kontrolą na żywo. Brak danych nie oznacza awarii.
Co można kupić za $10
- Wejście
- 7,1 mln tokenów
- Wyjście
- 2,3 mln tokenów
Szacunek na podstawie obecnych cen wejścia i wyjścia, bez rabatów.
Benchmarki
- 50%
Code Bench
poprawa względem GLM-5.2 w wewnętrznym benchmarku dostawcy
- 28.3
Terminal Bench 3.0
punktów; GLM-5.2 uzyskał 4.6, wzrost o 23.7 punktu
- 66.9
DeepSWE v1.1
punktów; wzrost z 46.2 na GLM-5.2, poprawa o 20.7 punktu
- 28.5
Agents' Last Exam CLI
punktów; wzrost z 23.8 na GLM-5.2
- 54.4%
ExploitBench
wzrost z 24.4% na GLM-5.2
- 84.5%
CyberGym
benchmark wykrywania podatności
- 1769
GDPval-AA v2
punktów w 44 kategoriach zawodowych
Wyniki zgodnie z publikacją dostawcy modelu.
Rozumowanie
- Domyślny poziom wysiłku
- max
- Włączone domyślnie
- Tak
- Zawsze włączone
- Tak
- Dostępne poziomy wysiłku
- max / high / low
Szybki start
Gotowy kod do wywołania tego modelu przez zgodne API Felo API Platform. Zacznij w Playground, gdy chcesz przetestować prompty przed pisaniem kodu.
Pobierz klucz API
Utwórz klucz w swoim koncie Felo API Platform i ustaw go jako zmienną środowiskową.
export FELO_API_KEY="YOUR_API_KEY"Wyślij pierwsze żądanie
Użyj tego identyfikatora modelu z endpointem Felo API Platform. Opcjonalne nagłówki żądania, takie jak X-Request-Id, mogą pomóc w diagnostyce.
glm-5.3Ten model obsługuje rozumowanie. Jeśli wybrany protokół i trasa modelu udostępniają elementy sterujące rozumowaniem, zachowaj zwrócone metadane rozumowania podczas kontynuowania rozmowy.
const response = await fetch("https://openapi.felo.ai/api/v1/messages", {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.FELO_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ]
}),
});
if (!response.ok) throw new Error(await response.text());
console.log(await response.json());
Korzystanie z zewnętrznych SDK
Używaj zgodnych SDK, ustawiając baseURL na https://openapi.felo.ai/api/v1. Użyj bazowego adresu URL zgodnego z Anthropic dla klientów w stylu Claude. https://openapi.felo.ai/api.
Włącz strumieniowanie
Dodaj stream: true, aby otrzymywać odpowiedzi jako server-sent events.
curl -N https://openapi.felo.ai/api/v1/messages \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ],
  "stream": true
}'
Endpoint
Felo API Platform udostępnia zgodne interfejsy wywoływania modeli. Wybierz ten, który Twoja aplikacja lub klient agenta już obsługuje.
Messages
Komunikaty zgodne z Anthropic dla klientów w stylu Claude.
POST
https://openapi.felo.ai/api/v1/messagesParametry
modelstringglm-5.3Publiczny identyfikator modelu do wywołania.max_tokensinteger—Maksymalna liczba generowanych tokenów.messagesarray—Komunikaty rozmowy dla Chat Completions.seed———stop———min_p———toolsarray—Definicje wywoływania narzędzi zgodne z obsługiwanym schematem.top_k———top_p———logprobs———reasoning———logit_bias———temperaturenumber—Steruje różnorodnością odpowiedzi, gdy jest obsługiwane.tool_choicestring or object—Steruje tym, czy narzędzie powinno zostać wywołane.top_logprobs———response_formatobject—Żąda ustrukturyzowanego wyniku, gdy jest obsługiwany.presence_penalty———reasoning_effort———frequency_penalty———include_reasoning———repetition_penalty———structured_outputs———parallel_tool_calls———Często zadawane pytania
Co to jest GLM 5.3?
GLM-5.3 to model językowy od Z.ai wydany 14 sierpnia 2026 roku, obsługujący wyłącznie tekst na wejściu i wyjściu. Oferuje kontekst do miliona tokenów oraz tryb myślenia z trzema poziomami wysiłku — low, high i max. Myślenia nie można już wyłączyć, co jest zmianą niekompatybilną dla aplikacji działających wcześniej bez tego trybu. Model wspiera strumieniowanie odpowiedzi, wywoływanie funkcji, buforowanie kontekstu i ustrukturyzowane wyjście, m.in. w formacie JSON. Model sprawdza się w długotrwałych pętlach agentowych, złożonych zadaniach inżynierii oprogramowania, wieloetapowej pracy w CLI, takiej jak refaktoryzacja i triage CI, a także w pracy na skalę całego repozytorium. Znajduje też zastosowanie w diagnostyce i optymalizacji infrastruktury ML oraz w szerszych zadaniach agentowych wykraczających poza programowanie. GLM-5.3 korzysta z dokładnie tej samej bazy co GLM-5.2 — architektury Mixture-of-Experts z 743 miliardami parametrów — a wszystkie ulepszenia pochodzą z post-trainingu. Z.ai opisuje go jako najzdolniejszy model z otwartymi wagami do kodowania oraz wskazuje czołowe wyniki wśród modeli otwartoźródłowych na Terminal Bench 3.0 i Agents' Last Exam. Te same efekty ma osiągać przy około 50 000 tokenów zamiast 120 000. Ograniczeniem jest brak niezależnej replikacji wyników dostawcy oraz nadal znacząco niższe możliwości od aktualnych zamkniętych modeli frontier.
Jak rozliczane jest użycie?
Rachunek zależy od wybranego dostawcy, jego cen i faktycznego zużycia. Dłuższe dane wejściowe lub inne warunki mogą mieć inne ceny.
Jakie dane wejściowe i wyjściowe obsługuje GLM-5.3?
Model przyjmuje tekst i zwraca tekst — nie obsługuje innych modalności.
Jaki jest limit kontekstu?
Kontekst wynosi do miliona tokenów. Limit wyjścia nie został podany w materiałach.
Czy można wyłączyć tryb myślenia?
Nie. GLM-5.3 oferuje trzy poziomy wysiłku myślenia — low, high i max — ale myślenia nie da się już wyłączyć.
Do jakich zadań najlepiej się nadaje?
Sprawdza się w długotrwałych pętlach agentowych, złożonych zadaniach programistycznych, wieloetapowej pracy w CLI oraz w zadaniach na skalę całego repozytorium.
Czym różni się od GLM-5.2?
Dzieli z GLM-5.2 tę samą bazę 743 miliardów parametrów, a wszystkie ulepszenia pochodzą z post-trainingu. Wprowadza też zmianę niekompatybilną: nie pozwala wyłączyć myślenia.
Powiązane modele
GLM 5.3 FlashX Legal
Z.aiglm-5.3-flashx-legalGLM 5.3 FlashX Legal to multimodalny model Z.ai do zadań prawniczych, łączący rozumienie dokumentów, rozumowanie prawnicze i planowanie działań, z kontekstem około miliona tokenów i szybkością około 200 tokenów na sekundę.
Kontekst
1.049M
Maks. wyjście
131.072K
Tokeny wejściowe
$0.37 / 1M tokenów
Tokeny wyjściowe
$1.25 / 1M tokenów
GLM 5.3 Flash
Z.aiglm-5.3-flashGLM 5.3 Flash to multimodalny model agentowy od Z.ai z kontekstem 1 miliona tokenów, natywnym wejściem tekstowym i obrazowym oraz niższymi kosztami wnioskowania niż flagowy GLM 5.3.
Kontekst
1.049M
Maks. wyjście
943.717K
Tokeny wejściowe
$0.15 / 1M tokenów
Tokeny wyjściowe
$0.5 / 1M tokenów