
GLM 5.3 API
GLM-5.3 von Z.ai ist ein Open-Weights-Modell für Coding-Agenten mit bis zu einer Million Token Kontext und drei Denkstufen.
GLM-5.3 ist ein Textmodell von Z.ai, das am 14. August 2026 erschienen ist und Kontextlängen von bis zu einer Million Token verarbeitet. Es unterstützt Ein- und Ausgabe in Textform sowie Streaming-Antworten, Funktionsaufrufe, Context Caching und strukturierte Ausgabe etwa im JSON-Format. Der Denkmodus lässt sich über die Stufen low, high und max steuern; ein vollständiges Abschalten des Denkens ist nicht mehr vorgesehen. Das Modell basiert auf derselben 743 Milliarden Parameter umfassenden Mixture-of-Experts-Architektur wie GLM-5.2, alle Verbesserungen stammen aus dem Post-Training.
Das Modell eignet sich besonders für langfristig laufende Coding-Agenten, komplexe Aufgaben der Softwareentwicklung und mehrstufige CLI-Arbeiten wie Refactorings oder CI-Triage. Auch lange Agentenschleifen, repositoryweite Aufgaben, die Diagnose und Optimierung von ML-Infrastruktur sowie agentische Aufgaben jenseits des Codings gehören zu den vorgesehenen Einsatzfeldern. Nach Angaben von Z.ai konzentrieren sich die Fortschritte auf mehrstufige Arbeiten statt auf einmalige Vervollständigungen; vergleichbare Ergebnisse sollen mit etwa 50.000 statt 120.000 Token erreichbar sein.
Z.ai bezeichnet GLM-5.3 als das leistungsfähigste Open-Weights-Modell für Coding und führt Bestwerte unter Open-Source-Modellen auf Terminal Bench 3.0 und Agents' Last Exam sowie auf CyberGym im Bereich der Schwachstellenerkennung. Die vom Anbieter gemeldeten Werte sind noch nicht unabhängig reproduziert. Die Fähigkeiten liegen weiterhin deutlich unter denen aktueller geschlossener Frontier-Modelle, und die Open Weights wurden nach dem Start für eine Sicherheitsprüfung um etwa zwei Wochen verzögert.
Aktualisiert:
MODELL-ID
glm-5.3- Kontext
- 1.049M
- Max. Ausgabe
- 943.718K
- Empfohlene API
- messages
- Eingabe
- text
- Ausgabe
- text
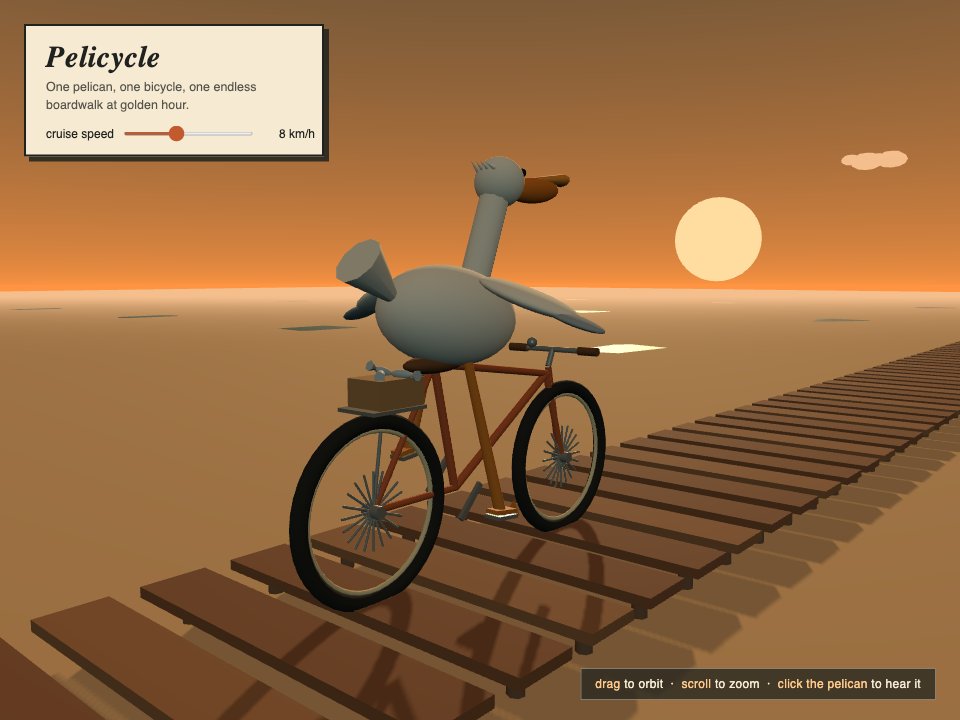
Den Pelikan dieses Modells ansehen
Sehen Sie, was GLM 5.3 aus demselben Prompt gemacht hat.
Highlights
- Kontext bis zu einer Million Token
- Drei Denkstufen: low, high, max
- Funktionsaufrufe und Context Caching
- Strukturierte Ausgabe wie JSON
- Open Weights für lokale Bereitstellung
- Auf mehrstufige Agentenarbeit ausgelegt
Anbieter
Bester PreisVergleichen Sie die API-Preise verschiedener Anbieter. Wählen Sie einen Anbieter aus, um alle Kosten und Bedingungen zu sehen.
| Verfügbarkeit | ||||
|---|---|---|---|---|
| $1.4 | $4.4 | $0.26 | ||
| $0.7 | $2.2 | $0.13 | ||
| $0.91 | $2.86 | $0.169 | ||
| $1.053 | $2.15 | $0.356 | ||
| $1.19 | $3.74 | $0.238 | ||
| $1.4 | $4.4 | $0.14 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.68 | $5.28 | $0.312 |
Historische Daten sind keine Live-Statusprüfung. Fehlende Daten bedeuten keinen Ausfall.
Was man für $10 bekommt
- Eingabe
- 7,1 Mio. Token
- Ausgabe
- 2,3 Mio. Token
Geschätzt anhand der aktuellen Eingabe- und Ausgabepreise, vor Rabatten.
Benchmarks
- 50%
Code Bench
Verbesserung gegenüber GLM-5.2 im hauseigenen Benchmark von Z.ai
- 28.3
Terminal Bench 3.0
Punkte; GLM-5.2 erreichte 4.6, ein Zuwachs von 23.7 Punkten
- 66.9
DeepSWE v1.1
Punkte; Anstieg von 46.2 bei GLM-5.2, eine Verbesserung um 20.7 Punkte
- 28.5
Agents' Last Exam CLI
Punkte; Anstieg von 23.8 bei GLM-5.2
- 54.4%
ExploitBench
Anstieg von 24.4% bei GLM-5.2
- 84.5%
CyberGym
Benchmark zur Schwachstellenerkennung
- 1769
GDPval-AA v2
Punkte über 44 Berufskategorien hinweg
Werte wie vom Modellanbieter veröffentlicht.
Schlussfolgern
- Standardaufwand
- max
- Standardmäßig aktiviert
- Ja
- Immer aktiviert
- Ja
- Verfügbare Aufwandsstufen
- max / high / low
Schnellstart
Direkt einsetzbarer Code, um dieses Modell über die kompatiblen APIs der Felo API Platform aufzurufen. Testen Sie Prompts im Playground, bevor Sie Code schreiben.
API-Schlüssel hinterlegen
Erstellen Sie einen Schlüssel in Ihrem Konto bei der Felo API Platform und legen Sie ihn als Umgebungsvariable ab.
export FELO_API_KEY="YOUR_API_KEY"Erste Anfrage senden
Verwenden Sie diese Modell-ID mit dem Endpoint der Felo API Platform. Optionale Anfrage-Header wie X-Request-Id helfen bei der Fehlersuche.
glm-5.3Dieses Modell kann schlussfolgern. Wenn das gewählte Protokoll und die Modellroute Reasoning-Steuerungen bereitstellen, behalten Sie die zurückgegebenen Reasoning-Metadaten bei, wenn Sie das Gespräch fortsetzen.
const response = await fetch("https://openapi.felo.ai/api/v1/messages", {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.FELO_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ]
}),
});
if (!response.ok) throw new Error(await response.text());
console.log(await response.json());
Drittanbieter-SDKs verwenden
Setzen Sie in kompatiblen SDKs baseURL auf https://openapi.felo.ai/api/v1. Für Clients im Claude-Stil verwenden Sie die Anthropic-kompatible Basis-URL. https://openapi.felo.ai/api.
Streaming aktivieren
Fügen Sie stream: true hinzu, um Antworten als Server-Sent Events zu erhalten.
curl -N https://openapi.felo.ai/api/v1/messages \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ],
  "stream": true
}'
Endpoint
Die Felo API Platform stellt kompatible Oberflächen für Modellaufrufe bereit. Wählen Sie die Oberfläche, die Ihre App oder Ihr Agent-Client bereits unterstützt.
Messages
Anthropic-kompatible Nachrichten für Clients im Claude-Stil.
POST
https://openapi.felo.ai/api/v1/messagesParameter
modelstringglm-5.3Öffentliche Modell-ID, die aufgerufen wird.max_tokensinteger—Maximale Anzahl generierter Tokens.messagesarray—Gesprächsnachrichten für Chat Completions.seed———stop———min_p———toolsarray—Tool-Calling-Definitionen nach kompatiblem Schema.top_k———top_p———logprobs———reasoning———logit_bias———temperaturenumber—Steuert die Vielfalt der Antworten, wenn unterstützt.tool_choicestring or object—Steuert, ob ein Tool aufgerufen werden soll.top_logprobs———response_formatobject—Fordert strukturierte Ausgabe an, wenn unterstützt.presence_penalty———reasoning_effort———frequency_penalty———include_reasoning———repetition_penalty———structured_outputs———parallel_tool_calls———Häufige Fragen
Was ist GLM 5.3?
GLM-5.3 ist ein Textmodell von Z.ai, das am 14. August 2026 erschienen ist und Kontextlängen von bis zu einer Million Token verarbeitet. Es unterstützt Ein- und Ausgabe in Textform sowie Streaming-Antworten, Funktionsaufrufe, Context Caching und strukturierte Ausgabe etwa im JSON-Format. Der Denkmodus lässt sich über die Stufen low, high und max steuern; ein vollständiges Abschalten des Denkens ist nicht mehr vorgesehen. Das Modell basiert auf derselben 743 Milliarden Parameter umfassenden Mixture-of-Experts-Architektur wie GLM-5.2, alle Verbesserungen stammen aus dem Post-Training. Das Modell eignet sich besonders für langfristig laufende Coding-Agenten, komplexe Aufgaben der Softwareentwicklung und mehrstufige CLI-Arbeiten wie Refactorings oder CI-Triage. Auch lange Agentenschleifen, repositoryweite Aufgaben, die Diagnose und Optimierung von ML-Infrastruktur sowie agentische Aufgaben jenseits des Codings gehören zu den vorgesehenen Einsatzfeldern. Nach Angaben von Z.ai konzentrieren sich die Fortschritte auf mehrstufige Arbeiten statt auf einmalige Vervollständigungen; vergleichbare Ergebnisse sollen mit etwa 50.000 statt 120.000 Token erreichbar sein. Z.ai bezeichnet GLM-5.3 als das leistungsfähigste Open-Weights-Modell für Coding und führt Bestwerte unter Open-Source-Modellen auf Terminal Bench 3.0 und Agents' Last Exam sowie auf CyberGym im Bereich der Schwachstellenerkennung. Die vom Anbieter gemeldeten Werte sind noch nicht unabhängig reproduziert. Die Fähigkeiten liegen weiterhin deutlich unter denen aktueller geschlossener Frontier-Modelle, und die Open Weights wurden nach dem Start für eine Sicherheitsprüfung um etwa zwei Wochen verzögert.
Wie wird die Nutzung abgerechnet?
Ihre Rechnung hängt vom genutzten Anbieter, seinen Preisen und Ihrer Nutzung ab. Längere Eingaben oder andere Bedingungen können andere Preise haben.
Welche Eingaben und Ausgaben unterstützt GLM-5.3?
GLM-5.3 verarbeitet Texteingaben und erzeugt Textausgaben. Streaming-Antworten, Funktionsaufrufe und strukturierte Ausgabeformate wie JSON werden unterstützt.
Wie lang kann der Kontext sein?
Der Kontext reicht laut Datenblatt bis zu einer Million Token. Ein separates Ausgabelimit wird in den vorliegenden Angaben nicht genannt.
Lässt sich der Denkmodus abschalten?
Nein. GLM-5.3 bietet die Denkstufen low, high und max, das vollständige Deaktivieren des Denkens ist nicht mehr möglich. Das ist eine Breaking Change für Anwendungen, die zuvor ohne Denken liefen.
Für welche Aufgaben ist das Modell gedacht?
Vorgesehen ist es für langfristige Coding-Agenten, komplexe Softwareentwicklung, mehrstufige CLI-Arbeiten, lange Agentenschleifen, repositoryweite Aufgaben, die Diagnose und Optimierung von ML-Infrastruktur sowie agentische Aufgaben außerhalb des Codings.
Worin unterscheidet sich GLM-5.3 von GLM-5.2?
Beide nutzen dieselbe Basisarchitektur mit 743 Milliarden Parametern als Mixture-of-Experts. Die Verbesserungen von GLM-5.3 stammen vollständig aus dem Post-Training, und das Abschalten des Denkens ist nicht mehr möglich.
Verwandte Modelle
GLM 5.3 FlashX Legal
Z.aiglm-5.3-flashx-legalZ.ai: GLM 5.3 FlashX Legal ist ein multimodales Rechtsmodell mit etwa einer Million Tokens Kontext, 128K Ausgabetokens und stets aktivem Denkmodus für Vertragsprüfung, Beweisanalyse und juristische Dokumentenworkflows.
Kontext
1.049M
Max. Ausgabe
131.072K
Eingabe-Token
$0.37 / 1M Token
Ausgabe-Token
$1.25 / 1M Token
GLM 5.3 Flash
Z.aiglm-5.3-flashGLM 5.3 Flash von Z.ai ist ein multimodales Mixture-of-Experts-Modell mit 1-Million-Token-Kontext, standardmäßig aktiviertem Reasoning und toolbasierter Agentensteuerung für kosteneffiziente Aufgaben.
Kontext
1.049M
Max. Ausgabe
943.717K
Eingabe-Token
$0.15 / 1M Token
Ausgabe-Token
$0.5 / 1M Token