
GLM 5.3 API
GLM-5.3 de Z.ai es un modelo de texto con contexto de hasta 1 millón de tokens, pensado para agentes de programación de largo recorrido y tareas agénticas complejas.
GLM-5.3 es un modelo de Z.ai que acepta entrada de texto y genera salida de texto, con una ventana de contexto de hasta 1 millón de tokens. Incorpora un modo de razonamiento con tres niveles de esfuerzo (low, high y max), y el pensamiento ya no puede desactivarse, lo que supone un cambio incompatible para las aplicaciones que funcionaban con el razonamiento apagado. Además, admite transmisión de mensajes en tiempo real, llamada a funciones para integrar herramientas, caché de contexto para optimizar conversaciones largas y salida estructurada en formatos como JSON.
Está diseñado para tareas de ingeniería de software y flujos agénticos que requieren varios pasos. Resulta adecuado para agentes de programación de largo recorrido, trabajo a escala de repositorio, tareas de CLI de varios pasos como refactorizaciones y triaje de CI, bucles de agentes de larga duración, diagnóstico y optimización de infraestructura de ML, y tareas agénticas más amplias que van más allá de la programación. Sus mejoras se concentran en el trabajo de varios pasos más que en las respuestas de un solo intento, y según Z.ai puede realizar trabajo comparable con aproximadamente 50.000 tokens en lugar de 120.000.
El modelo utiliza la misma arquitectura de modelo base que GLM-5.2, una arquitectura Mixture-of-Experts de 743.000 millones de parámetros, y todas las mejoras provienen del post-entrenamiento. Las cifras reportadas por el proveedor aún no han sido replicadas de forma independiente, y las capacidades siguen siendo significativamente inferiores a las de los modelos frontera cerrados actuales. El acceso está limitado actualmente al GLM Coding Plan, la API del modelo solo está disponible mediante el protocolo compatible con OpenAI Chat Completion, el SDK de Z.ai se instala con pip install zai-sdk y se puede usar el SDK de OpenAI con la URL base https://api.z.ai/api/paas/v4/.
Actualizado:
ID DEL MODELO
glm-5.3- Contexto
- 1.049M
- Salida máx.
- 943.718K
- API recomendada
- messages
- Entrada
- text
- Salida
- text
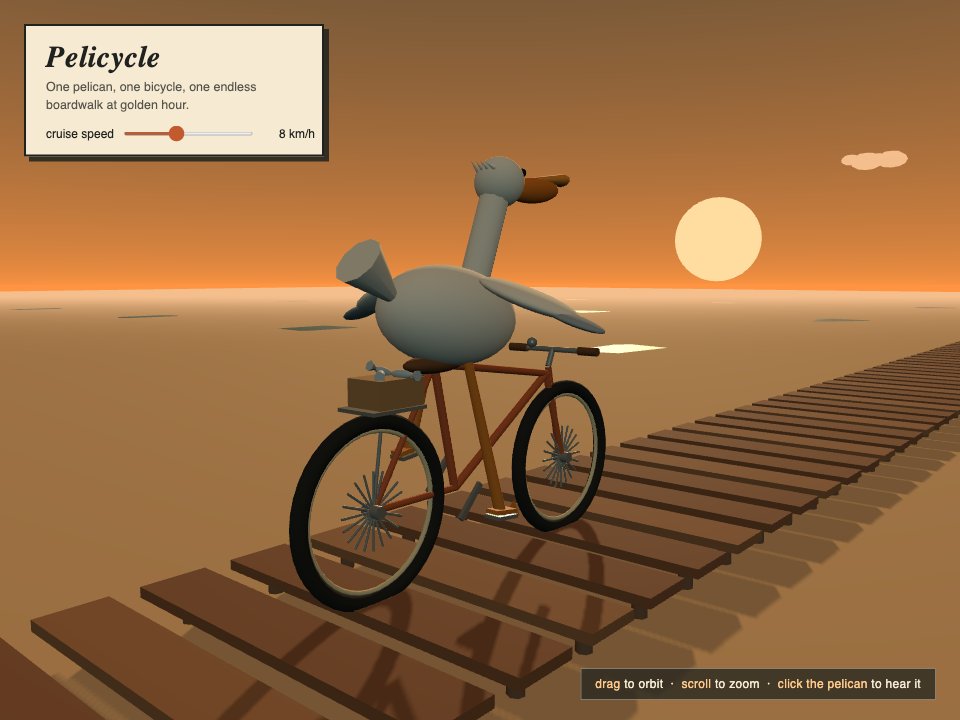
Mira el pelícano de este modelo
Descubre qué creó GLM 5.3 a partir de la misma instrucción.
Aspectos destacados
- Contexto de hasta 1 millón de tokens
- Tres niveles de esfuerzo de razonamiento
- El pensamiento ya no se puede desactivar
- Llamada a funciones y salida estructurada
- Caché de contexto para conversaciones largas
- Mejoras centradas en trabajo de varios pasos
Proveedores
Mejor precioCompara los precios de API entre proveedores. Selecciona un proveedor para ver todos los cargos y condiciones.
| Disponibilidad | ||||
|---|---|---|---|---|
| $1.4 | $4.4 | $0.26 | ||
| $0.7 | $2.2 | $0.13 | ||
| $0.91 | $2.86 | $0.169 | ||
| $1.053 | $2.15 | $0.356 | ||
| $1.19 | $3.74 | $0.238 | ||
| $1.4 | $4.4 | $0.14 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.4 | $4.4 | $0.26 | ||
| $1.68 | $5.28 | $0.312 |
Las estadísticas históricas no son una comprobación en tiempo real. La falta de datos no implica una interrupción.
Qué puedes comprar con $10
- Entrada
- 7,1 M tokens
- Salida
- 2,3 M tokens
Estimado a partir de los precios actuales de entrada y salida, antes de descuentos.
Benchmarks
- 50%
Code Bench
mejora respecto a GLM-5.2, benchmark interno del proveedor
- 28.3
Terminal Bench 3.0
puntos; GLM-5.2 obtuvo 4.6, una ganancia de 23.7 puntos
- 66.9
DeepSWE v1.1
puntos; sube desde 46.2 en GLM-5.2, una mejora de 20.7 puntos
- 28.5
Agents' Last Exam CLI
puntos; sube desde 23.8 en GLM-5.2
- 54.4%
ExploitBench
sube desde 24.4% en GLM-5.2
- 84.5%
CyberGym
benchmark de descubrimiento de vulnerabilidades
- 1769
GDPval-AA v2
puntos en 44 categorías ocupacionales
Puntuaciones según lo publicado por el proveedor del modelo.
Razonamiento
- Esfuerzo predeterminado
- max
- Activado por defecto
- Sí
- Siempre activado
- Sí
- Niveles de esfuerzo disponibles
- max / high / low
Inicio rápido
Código listo para llamar a este modelo con las APIs compatibles de Felo API Platform. Empieza en el Playground si quieres probar prompts antes de escribir código.
Configura tu clave de API
Crea una clave en tu cuenta de Felo API Platform y configúrala como variable de entorno.
export FELO_API_KEY="YOUR_API_KEY"Haz tu primera solicitud
Usa este ID de modelo con el endpoint de Felo API Platform. Las cabeceras opcionales como X-Request-Id ayudan a diagnosticar problemas.
glm-5.3Este modelo puede razonar. Si el protocolo seleccionado y la ruta del modelo exponen controles de razonamiento, conserva los metadatos de razonamiento devueltos al continuar la conversación.
const response = await fetch("https://openapi.felo.ai/api/v1/messages", {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.FELO_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ]
}),
});
if (!response.ok) throw new Error(await response.text());
console.log(await response.json());
Usar SDK de terceros
En los SDK compatibles, define baseURL como https://openapi.felo.ai/api/v1. Para clientes de estilo Claude, usa la URL base compatible con Anthropic. https://openapi.felo.ai/api.
Activa el streaming
Añade stream: true para recibir respuestas como server-sent events.
curl -N https://openapi.felo.ai/api/v1/messages \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "glm-5.3",
  "max_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello"
    }
  ],
  "stream": true
}'
Endpoint
Felo API Platform expone superficies compatibles para llamar a modelos. Elige la superficie que tu app o cliente de agente ya admite.
Messages
Mensajes compatibles con Anthropic para clientes de estilo Claude.
POST
https://openapi.felo.ai/api/v1/messagesParámetros
modelstringglm-5.3ID público del modelo que se va a llamar.max_tokensinteger—Número máximo de tokens generados.messagesarray—Mensajes de la conversación para Chat Completions.seed———stop———min_p———toolsarray—Definiciones de tool calling según el esquema compatible.top_k———top_p———logprobs———reasoning———logit_bias———temperaturenumber—Controla la variedad de las respuestas cuando es compatible.tool_choicestring or object—Controla si se debe llamar a una herramienta.top_logprobs———response_formatobject—Solicita salida estructurada cuando es compatible.presence_penalty———reasoning_effort———frequency_penalty———include_reasoning———repetition_penalty———structured_outputs———parallel_tool_calls———Preguntas frecuentes
¿Qué es GLM 5.3?
GLM-5.3 es un modelo de Z.ai que acepta entrada de texto y genera salida de texto, con una ventana de contexto de hasta 1 millón de tokens. Incorpora un modo de razonamiento con tres niveles de esfuerzo (low, high y max), y el pensamiento ya no puede desactivarse, lo que supone un cambio incompatible para las aplicaciones que funcionaban con el razonamiento apagado. Además, admite transmisión de mensajes en tiempo real, llamada a funciones para integrar herramientas, caché de contexto para optimizar conversaciones largas y salida estructurada en formatos como JSON. Está diseñado para tareas de ingeniería de software y flujos agénticos que requieren varios pasos. Resulta adecuado para agentes de programación de largo recorrido, trabajo a escala de repositorio, tareas de CLI de varios pasos como refactorizaciones y triaje de CI, bucles de agentes de larga duración, diagnóstico y optimización de infraestructura de ML, y tareas agénticas más amplias que van más allá de la programación. Sus mejoras se concentran en el trabajo de varios pasos más que en las respuestas de un solo intento, y según Z.ai puede realizar trabajo comparable con aproximadamente 50.000 tokens en lugar de 120.000. El modelo utiliza la misma arquitectura de modelo base que GLM-5.2, una arquitectura Mixture-of-Experts de 743.000 millones de parámetros, y todas las mejoras provienen del post-entrenamiento. Las cifras reportadas por el proveedor aún no han sido replicadas de forma independiente, y las capacidades siguen siendo significativamente inferiores a las de los modelos frontera cerrados actuales. El acceso está limitado actualmente al GLM Coding Plan, la API del modelo solo está disponible mediante el protocolo compatible con OpenAI Chat Completion, el SDK de Z.ai se instala con pip install zai-sdk y se puede usar el SDK de OpenAI con la URL base https://api.z.ai/api/paas/v4/.
¿Cómo se cobra el uso?
Tu factura depende del proveedor que uses, de sus precios y de tu uso. Las entradas más largas u otras condiciones pueden tener precios distintos.
¿Qué tipos de entrada y salida admite GLM-5.3?
Admite entrada de texto y salida de texto. También ofrece salida estructurada en formatos como JSON y llamada a funciones para integrar herramientas.
¿Cuál es la ventana de contexto de GLM-5.3?
La ventana de contexto es de hasta 1 millón de tokens. El límite de salida no se especifica en la documentación disponible.
¿Qué niveles de razonamiento ofrece?
Ofrece tres niveles de esfuerzo de pensamiento: low, high y max. El pensamiento ya no puede desactivarse.
¿Para qué tareas está pensado GLM-5.3?
Está pensado para tareas agénticas y de ingeniería de software de varios pasos, como agentes de programación de largo recorrido, refactorizaciones, triaje de CI y trabajo a escala de repositorio.
¿En qué se diferencia GLM-5.3 de GLM-5.2?
Comparte el mismo modelo base que GLM-5.2, pero todas las mejoras provienen del post-entrenamiento. Además, GLM-5.3 ya no permite desactivar el pensamiento, lo que es un cambio incompatible respecto a GLM-5.2.
Modelos relacionados
GLM 5.3 FlashX Legal
Z.aiglm-5.3-flashx-legalGLM 5.3 FlashX Legal es un modelo multimodal de Z.ai orientado a inteligencia legal agéntica, con contexto de aproximadamente un millón de tokens y salida de 128K.
Contexto
1.049M
Salida máx.
131.072K
Tokens de entrada
$0.37 / 1M tokens
Tokens de salida
$1.25 / 1M tokens
GLM 5.3 Flash
Z.aiglm-5.3-flashGLM 5.3 Flash es un modelo de Z.ai con arquitectura de mezcla de expertos, contexto de un millón de tokens y entrada nativa de texto e imágenes para tareas de agente y automatización.
Contexto
1.049M
Salida máx.
943.717K
Tokens de entrada
$0.15 / 1M tokens
Tokens de salida
$0.5 / 1M tokens